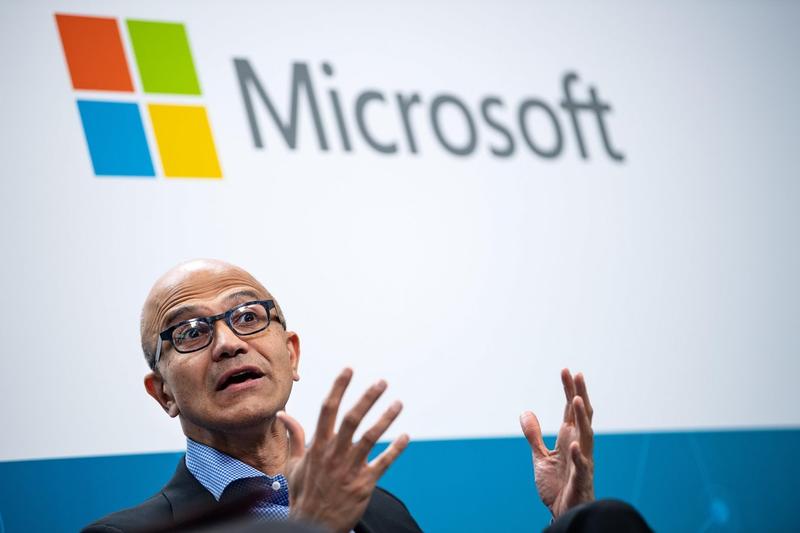
Conform HotNews: Gigantul Microsoft trage un semnal de alarmă: Companiile își vând datele sensibile prin intermediul modelelor AI
Satya NADELLA, CEO-ul Microsoft, a lansat un avertisment surprinzător în cercurile tehnologice, atrăgând atenția asupra unui risc major pe care companiile și-l asumă atunci când folosesc modele de inteligență artificială (AI) oferite de marii furnizori. Acesta susține că, pe lângă plata pentru serviciile AI, companiile își cedează, involuntar, informații extrem de valoroase, care ar putea fi folosite ulterior de furnizori în scopuri concurențiale.
„Plătiți pentru inteligență de două ori”
Îngrijorarea principală vizează modul în care modelele AI, precum cele dezvoltate de OpenAI sau Anthropic, pot accesa și procesa datele sensibile ale clienților. Pe măsură ce startup-urile și companiile își integrează aceste instrumente în operațiunile zilnice, informațiile despre strategii de afaceri, secrete comerciale și procese interne ajung să fie, într-un fel, „hrănite” algoritmilor.
NADELLA compară acest proces cu o dublă plată. Pe de o parte, companiile achită costurile legate de utilizarea „token-urilor AI”, unitatea de măsură pentru consumul acestor servicii. Pe de altă parte, ele cedează, fără să realizeze pe deplin, cunoștințe proprietare. „Cu cât vrei ca modelul să aibă performanțe mai bune, cu atât trebuie să îl hrănești cu mai multe dintre aceste cunoștințe!”, a explicat CEO-ul Microsoft într-o postare pe blogul său, citată de TechCrunch.
AI-ul „distilează” secretele companiilor
CEO-ul Microsoft subliniază că modelele AI învață din „reziduuri”: din comenzile (prompt-urile) introduse de utilizatori, din instrumentele AI folosite și, cel mai important, din corecturile aduse atunci când modelul greșește. Fiecare interacțiune, fiecare ajustare contribuie la o acumulare de „know-how” instituțional, pe care NADELLA îl descrie ca fiind „genul de cunoaștere pe care un concurent nu ar putea niciodată să o cumpere”.
Această perspectivă ridică semne de întrebare cu privire la echilibrul de putere dintre furnizorii de AI și clienții lor. În timp ce furnizorii își antrenează liber modelele pe date publice, companiile care apelează la aceste servicii riscă să își dezvăluie vulnerabilitățile strategice. NADELLA consideră ipocrită situația în care furnizorii își antrenează modelele pe date globale, dar interzic cercetarea sau „distilarea” acestora de către terți.
„Distilarea” se referă la procesul prin care rezultatele unui model AI sunt folosite pentru a antrena un nou model, potențial mai accesibil. Incidentul în care Anthropic a acuzat companii chineze că au folosit modelul Claude pentru a-și îmbunătăți propriile algoritmi amplifică aceste temeri.
Soluția Microsoft: Controlul datelor și interoperabilitatea
Ca răspuns la aceste provocări, Microsoft propune o strategie centrată pe conservarea proprietății datelor de către companii. NADELLA pledează pentru implementarea unor „straturi de orchestrare” care să permită firmelor să schimbe cu ușurință între diferiți furnizori de modele AI, evitând astfel dependența de un singur producător.
„Atunci când consumi inteligență, creezi, la rândul tău, inteligență. Iar ceea ce creezi ar trebui să îți aparțină”, a concluzionat NADELLA, subliniind importanța ca datele generate prin interacțiunea cu AI să rămână proprietatea utilizatorului. Această abordare reflectă poziția Microsoft, cel mai mare investitor în OpenAI, compania din spatele ChatGPT.
Sursa: HotNews

Articole similare
Fii primul care comentează